Vous êtes invisible, et personne ne vous dit pourquoi
Vous avez un site. Il est propre, il fonctionne, vos clients le trouvent joli. Mais dans Google, il n’existe presque pas : vous tapez les requêtes qui comptent pour votre métier et vous n’apparaissez nulle part. Vous demandez pourquoi. On vous répond « il faut publier plus de contenu », « il faut des backlinks », « il faut attendre ». Parfois, le problème n’est ni le contenu ni la popularité : il est technique, et invisible à l’œil nu. Parfois, au contraire, l’audit montre un site techniquement sain dont le frein est ailleurs. Dans les deux cas, mieux vaut le savoir avant d’investir.
Un audit SEO technique, c’est exactement ça : mettre le nez dans les entrailles du site pour comprendre ce qui empêche Google de lire correctement vos pages. Pas un rapport de 90 pages que personne n’ouvre : mes audits tiennent en une vingtaine de pages. Un diagnostic clair : voilà ce qui bloque, voilà l’impact, voilà dans quel ordre corriger.
On trouve en ligne d’excellents guides pour faire cet audit soi-même. D’autres pages gardent le détail derrière un formulaire. Cette page fait l’inverse : je vous montre d’abord comment je travaille et ce que je regarde réellement, puis on parle de votre site si le sujet vous parle.
En bref
- Un audit SEO technique vérifie ce que Google peut explorer, rendre, comprendre et indexer sur votre site – et ce qui l’en empêche.
- Les blocages les plus fréquents ne sont pas dans le contenu :
robots.txt, canonicals contradictoires, sitemap qui envoie Google vers les mauvaises URL, contenu injecté en JavaScript, redirections en chaîne. - Une checklist appliquée à la main ne voit presque jamais trois choses : les logs serveur (ce que Googlebot demande vraiment), les conflits de signaux entre canonical HTML, en-tête HTTP et redirections, et le crawl budget gaspillé.
- Je réalise ces audits sur WordPress, et je peux aussi auditer un site Shopify, Wix ou sur mesure : j’y fournis des spécifications que votre prestataire applique.
- Le livrable : un rapport priorisé par impact, avec des correctifs exploitables, et une restitution orale.
Ce que je vérifie dans un audit SEO technique
Chaque bloc ci-dessous répond à une seule question : est-ce que ça empêche Google de faire son travail, oui ou non ? Et si oui, qu’est-ce que ça vous coûte concrètement ?
Crawl et robots.txt : Google a-t-il le droit d’entrer ?
Le fichier robots.txt est la première porte du site. Il dit aux robots ce qu’ils peuvent explorer. Une ligne mal placée – un Disallow: / ajouté par réflexe, un dossier bloqué par erreur – et des pages entières deviennent invisibles. Je vérifie le contenu réel du fichier, les directives noindex au niveau des pages, les en-têtes HTTP X-Robots-Tag, et l’accès de Googlebot aux ressources nécessaires au rendu (CSS, JavaScript).
Cas réel : sur le site d’un organisme de formation que j’ai audité, le robots.txt bloquait un sous-domaine entier, celui de sa plateforme e-learning. Ici, c’était voulu. Mais chaque blocage doit être une décision, pas un oubli : je le fais toujours confirmer par le client.
Je contrôle aussi un piège classique : bloquer une page dans robots.txt pour la retirer de l’index. Ça ne fonctionne pas. Google doit pouvoir explorer une page pour lire la consigne noindex qu’elle contient – bloquez-la et il ne la verra jamais. La documentation officielle est claire : robots.txt et blocage de l’indexation.
Impact business : une page produit, une page service ou une fiche contact invisible, c’est un prospect qui passe à côté. Et si un environnement de test est resté accessible, ce sont des dizaines de pages doublons qui polluent l’index.
Indexation et canonicals : la bonne version est-elle dans l’index ?
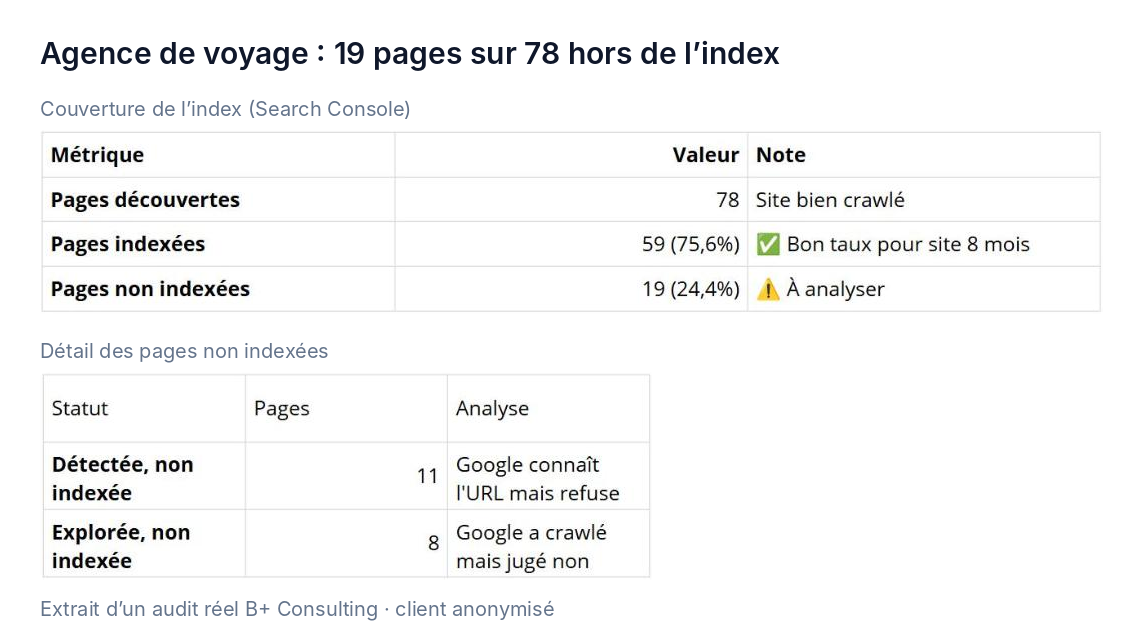
Explorer ne suffit pas. Il faut que la bonne version de chaque page soit indexée. Je croise trois sources : les URL trouvées par un crawl complet, celles présentes dans votre sitemap, et celles que Google a réellement indexées (rapport « Pages » de la Search Console). Les écarts racontent presque toujours une histoire.
Cas réel : sur le site d’une jeune agence de voyage (8 mois d’existence), Google avait découvert 78 pages mais n’en indexait que 59. Les 19 autres étaient « détectées » ou « explorées, actuellement non indexées » : des pages de destinations trop semblables entre elles, des pages de moins de 300 mots, et des templates Elementor qui n’avaient rien à faire dans l’index. La correction : enrichir les pages voyages, passer les templates en noindex et les retirer du sitemap.
Autre cas, sur un site de coaching sportif : 627 pages étaient en attente ou refusées. Une partie venait d’URL de campagnes publicitaires (?utm_source=…), que Google écarte à juste titre pour éviter les doublons : rien à corriger. Le reste, c’étaient des pages de quartiers trop pauvres en texte unique. Là, il y avait du travail.
Ensuite, les balises canonical. Une page peut pointer vers elle-même avec rel="canonical" (canonical auto-référent) : Google ne l’impose pas, mais c’est une bonne habitude qui lève les ambiguïtés. Les problèmes arrivent quand une page pointe vers une autre version, quand plusieurs URL identiques pointent chacune ailleurs, ou quand le canonical contredit le sitemap. Google documente les bonnes pratiques ici : consolider les URL en double.
Impact business : des signaux contradictoires laissent Google choisir à votre place quelle version afficher. Sur le site d’un centre de formation, une double balise canonical présente sur 171 pages a ainsi conduit Google à ignorer la canonique déclarée sur 6 pages – sans qu’aucun contenu ne soit en cause.
Sitemaps XML : la carte routière est-elle juste ?
Le sitemap XML n’oblige pas Google à indexer, mais il l’aide à découvrir vos pages et lui indique celles que vous privilégiez. Un sitemap sale fait l’inverse du travail attendu : il envoie le robot vers des URL redirigées, des pages noindex, des erreurs 404 ou des doublons.
Je vérifie que le sitemap ne contient que des URL canoniques, indexables, qui répondent en 200, qu’il est bien déclaré (dans robots.txt et dans la Search Console), et qu’il reflète la structure réelle du site. Voir les sitemaps selon Google.
Exemple : chez l’agence de voyage citée plus haut, des templates techniques figuraient dans le sitemap, présentés à Google comme des pages à indexer. Sur un autre site, le sitemap déclarait la même fréquence de mise à jour pour toutes les URL : rien de bloquant, mais un signal qui n’apporte aucune information.
Impact business : sur un site qui publie régulièrement, un sitemap à jour accélère la découverte des nouveautés. Un sitemap erroné gaspille du temps de crawl sur des pages sans valeur.
Rendu JavaScript : Google voit-il ce que vous voyez ?
De plus en plus de sites affichent leur contenu grâce à JavaScript : menus qui se déploient, prix chargés dynamiquement, textes injectés après le chargement. Google sait exécuter JavaScript, mais dans des conditions qui ne pardonnent pas l’approximation : ressources bloquées, délais, contenus ajoutés seulement au clic.
Je compare donc le HTML brut (ce que le serveur renvoie) et le HTML rendu (ce que Google voit après exécution du JavaScript). Si votre contenu, vos liens ou vos métadonnées n’apparaissent que dans le rendu, il y a un risque. Google recommande d’ailleurs le rendu côté serveur quand c’est possible : JavaScript et SEO et le rendu dynamique comme simple contournement.
Impact business : un contenu que Google ne voit pas est un contenu qui n’existe pas. Titres, textes, liens internes, prix, stock – tout ce qui n’est pas rendu est perdu pour le référencement.
Performance et Core Web Vitals : le site est-il agréable à charger ?
Les Core Web Vitals sont trois mesures d’expérience réelle. En 2026, les seuils à viser restent : LCP ≤ 2,5 s (affichage du contenu principal), INP ≤ 200 ms (réactivité aux interactions), CLS ≤ 0,1 (stabilité visuelle). Google les évalue au 75e percentile des visites, séparément sur mobile et ordinateur (détail des seuils).
Attention à ne pas confondre les mesures de laboratoire (un test dans un outil) et les données de terrain issues des vrais visiteurs, celles qui comptent (rapport Core Web Vitals dans la Search Console). Un bon score en labo peut cacher de mauvaises données réelles.
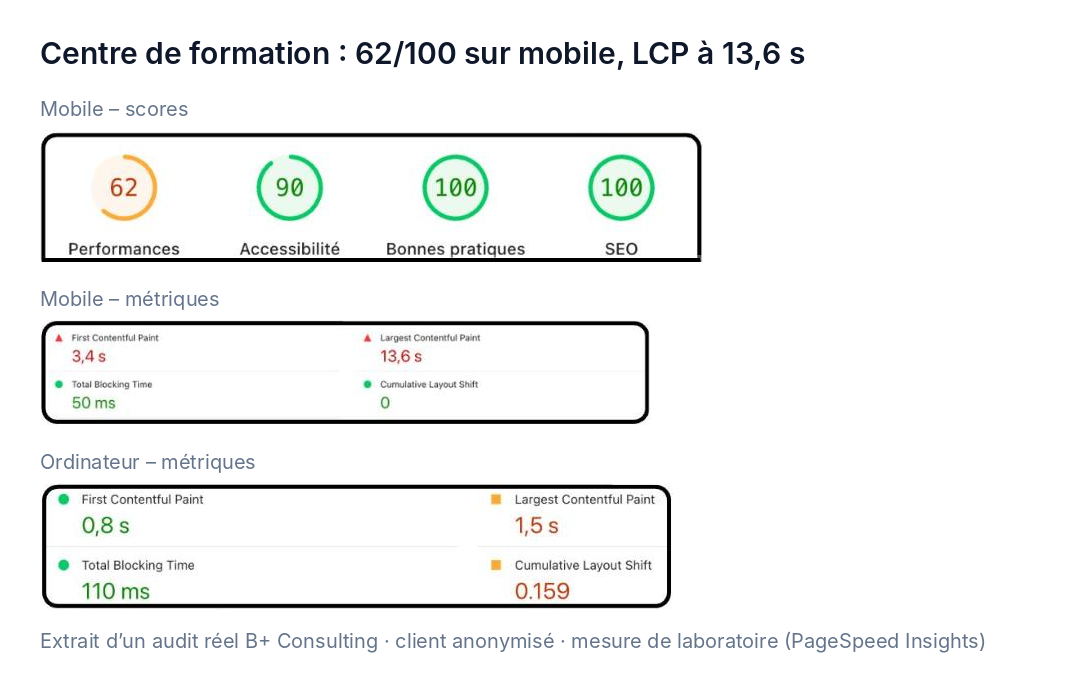
Cas réel : sur le site d’un centre de formation dont 75 % des clics venaient du mobile, le test affichait 86/100 sur ordinateur mais 62/100 sur mobile, avec un LCP de 13,6 s, plus de cinq fois le seuil de 2,5 s. Sur ordinateur, la stabilité visuelle dépassait elle aussi le seuil (CLS de 0,159).
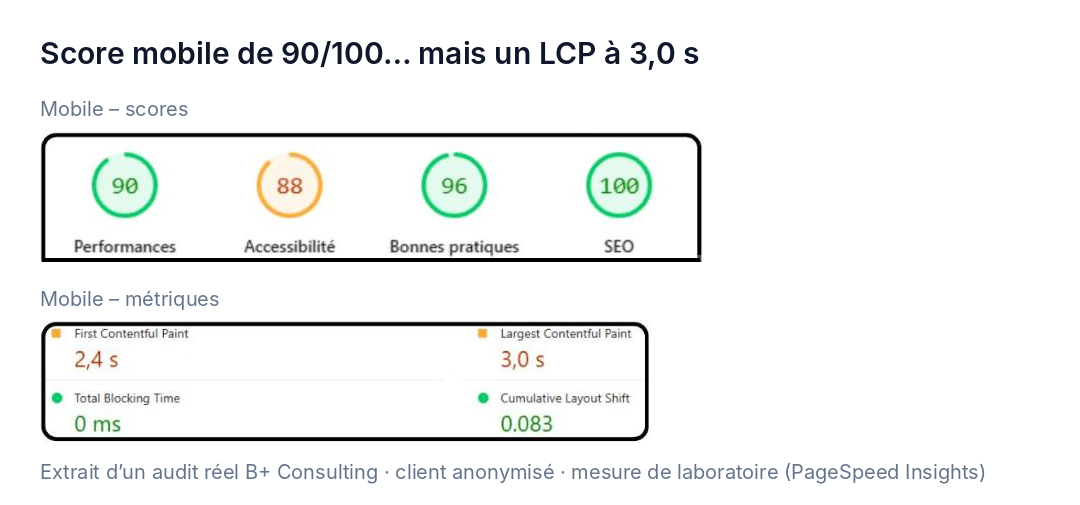
À l’inverse, une bonne note ne prouve rien à elle seule : sur un autre site, PageSpeed affichait 90/100 sur mobile… avec un LCP de 3,0 s, au-dessus du seuil. C’est la métrique qui compte, pas la note.
Impact business : un site lent fait fuir avant d’avoir convaincu, et une page qui « saute » pendant le chargement fait cliquer au mauvais endroit. La performance n’est pas qu’un sujet de référencement, c’est un sujet de conversion.
Redirections : le trafic arrive-t-il au bon endroit ?
Une refonte, un changement d’URL, une page renommée : à chaque fois, des redirections entrent en jeu. Je traque les chaînes de redirection (A → B → C, qui ralentissent l’exploration et multiplient les points de défaillance), les boucles, les redirections temporaires qui auraient dû être permanentes, et surtout les liens internes qui pointent encore vers d’anciennes URL redirigées.
Impact business : chaque maillon inutile, c’est du temps de crawl perdu et une chance de perdre le visiteur en route. Une redirection mal configurée, c’est aussi le risque de voir Google conserver l’ancienne URL dans ses résultats (les redirections selon Google).
Cas réel : sur le site d’un organisme de formation, un lien interne pointait vers /contact au lieu de /contact/ : une redirection 301 inutile, à chaque clic et à chaque passage de Google. Sur le même site, une plaquette PDF mise à jour avait laissé derrière elle un lien vers l’ancienne version, en 404.
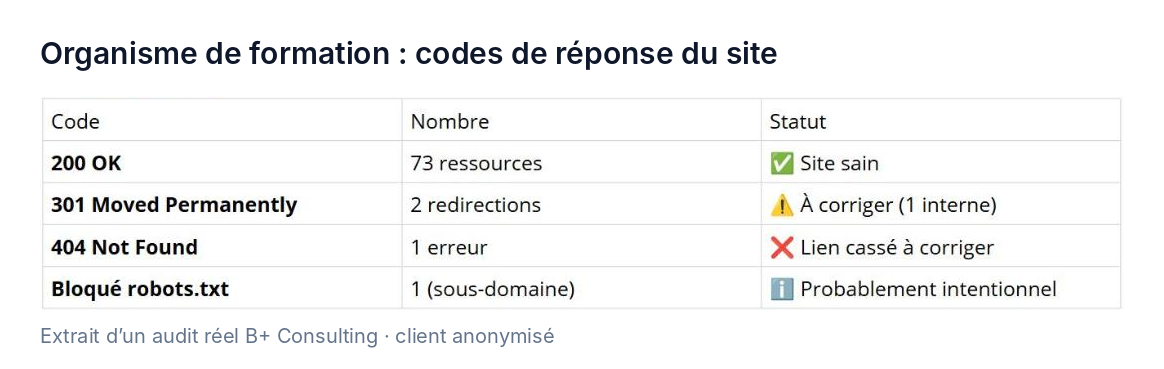
Sur un autre site, deux URL mortes recevaient chacune 171 liens internes : le lien cassé était dans le template, donc présent sur toutes les pages. Au total, 19 URL en 404, dont 14 pages formations encore liées en interne. Priorité absolue, sous 48 h : corriger le lien du template, puis rediriger en 301 vers les pages équivalentes.
Données structurées : parlez-vous la langue des moteurs ?
Les données structurées (au format JSON-LD, selon le vocabulaire de Schema.org) décrivent votre contenu aux moteurs : ceci est une entreprise, ceci est un produit, ceci est un avis, ceci est une FAQ. Bien posées, elles rendent vos résultats plus clairs et facilitent la compréhension par les moteurs classiques comme par les moteurs génératifs.
Je vérifie que le balisage est valide, qu’il correspond au contenu visible de la page et que les types réellement utiles sont en place (Organization, LocalBusiness, Product, Course, Article, BreadcrumbList). Le test des résultats enrichis de Google sert de contrôle (introduction aux données structurées).
Une précision : je ne vous vendrai pas le balisage FAQ comme un levier de visibilité. Google a réservé ces résultats enrichis aux sites gouvernementaux et de santé en 2023 (annonce de Google), puis annoncé leur abandon.
Cas réel : sur le site d’un centre de formation, les étoiles d’avis apparaissaient puis disparaissaient des résultats depuis plusieurs semaines. Premier réflexe : passer le balisage au test des résultats enrichis et le stabiliser. Et sur ses pages formations, les concurrents du top 4 avaient tous un balisage Course ; lui non.
Impact business : un balisage correct ne fait jamais grimper un site à lui seul, mais il améliore la fiabilité avec laquelle les moteurs (et les IA) comprennent votre offre. Un balisage qui contredit le contenu envoie de mauvais signaux.
hreflang : la bonne langue pour le bon visiteur
Si votre site existe en plusieurs langues ou vise plusieurs pays francophones (France, Belgique, Suisse, Canada, Afrique de l’Ouest…), les balises hreflang indiquent à Google quelle version servir à qui. Je vérifie que chaque version pointe vers toutes les autres et vers elle-même, que les codes de langue sont valides (fr-FR, fr-BE, fr-CA…), qu’une version x-default est prévue et que hreflang ne contredit pas les canonicals (versions localisées de vos pages).
Impact business : mal configuré, hreflang fait afficher la mauvaise version à la mauvaise audience – un visiteur belge qui tombe sur une offre pensée pour le Canada, ou des versions linguistiques qui se cannibalisent au lieu de se renforcer.
Ce qu’un audit manuel ne détecte pas
Une checklist appliquée à la main, avec un outil gratuit, permet déjà de repérer beaucoup de choses. C’est utile, et je vous encourage à le faire. Mais trois angles restent presque toujours hors de portée – et sur les sites volumineux ou complexes, ce sont souvent eux qui expliquent une stagnation.
Les logs serveur : ce que Googlebot demande vraiment
Les outils de crawl simulent le passage d’un robot. Les logs serveur, eux, montrent ce qui s’est réellement passé : quelles URL Googlebot a demandées, à quelle fréquence et avec quel code de réponse. C’est la différence entre supposer et savoir.
Je commence par vérifier que les visites sont bien de Googlebot et pas d’un imitateur, avec la méthode officielle (résolution DNS inverse puis directe) décrite par Google. Je regarde ensuite où va ce temps de crawl : des milliers de requêtes sur des URL filtrées ou la recherche interne, pendant que vos pages stratégiques ne sont presque jamais visitées. C’est le fameux crawl budget gaspillé, un sujet qui concerne surtout les gros sites : Google le réserve aux sites de plus d’un million de pages, ou de plus de 10 000 pages qui changent chaque jour (gérer le budget de crawl). Sur un site vitrine, ce n’est presque jamais le problème, et je ne vous le facturerai pas comme tel.
Les conflits de canonicals
Un canonical n’est pas une décision isolée. Il y a souvent plusieurs sources en même temps : la balise HTML, l’en-tête HTTP, la redirection, l’entrée dans le sitemap, les liens internes. Quand ces signaux se contredisent – l’HTML désigne une page comme référence, l’en-tête dit autre chose, une redirection envoie ailleurs – Google doit trancher à votre place. Ce type de conflit échappe à une relecture page à page : il faut croiser les sources pour le voir.
C’est le cas du centre de formation évoqué plus haut : deux balises canonical sur chaque page d’un site WordPress, l’une posée par le thème, l’autre par le plugin SEO. Résultat dans la Search Console : des pages pour lesquelles Google a ignoré la canonique déclarée. La correction tient en un réglage ; encore fallait-il trouver le conflit.
Les redirections et la profondeur cachées par le JavaScript
Trois niveaux de redirection qui s’enchaînent, des liens internes générés en JavaScript que le crawl brut ne voit pas, une page importante atteignable seulement après un clic : autant de chemins que seuls un crawl rendu et une lecture des logs révèlent. Sur ce type de site, un audit manuel « classique » peut passer à côté de la cause principale.
Ma méthode, étape par étape
Je travaille de façon reproductible, pour que vous sachiez à quoi vous attendre.
1. Cadrage et accès
Un échange pour comprendre votre activité, vos pages qui comptent (celles qui apportent des clients), vos contraintes et votre historique (refonte, migration, changement de domaine). Je demande les accès nécessaires : Google Search Console, éventuellement les logs serveur, un accès en lecture au site. Sans Search Console ni logs, l’audit reste possible, mais plus limité – je vous le dis dès le départ.
2. Crawl et collecte
Crawl complet du site (crawl brut et crawl rendu), relevé des codes de réponse, des balises robots, des canonicals, des titres, des données structurées, de la profondeur de clic et du maillage interne. Comparaison avec le sitemap et avec les données de la Search Console.
3. Analyse approfondie
C’est le cœur du travail : analyse des logs quand ils sont disponibles, mesure des Core Web Vitals sur les gabarits les plus fréquentés, test du rendu des pages clés, vérification des redirections et des signaux contradictoires.
4. Priorisation
Tous les problèmes ne se valent pas. Je classe chaque point selon deux axes : l’impact (est-ce que ça bloque l’exploration, l’indexation, la visibilité ou la conversion ?) et l’effort (est-ce long à corriger ?). Vous obtenez une liste dans l’ordre où il faut agir, pas un inventaire alphabétique.
Concrètement, chaque action reçoit une priorité et un temps estimé. Sur un audit récent : ajouter le H1 manquant de la page d’accueil, 15 minutes ; réécrire une meta description de 447 caractères qui commençait par un numéro SIRET, 15 minutes ; corriger un lien cassé présent dans tout le template, priorité absolue, sous 48 h.
5. Livrables et restitution
Vous recevez un rapport priorisé : pour chaque problème, les URL ou gabarits concernés, la preuve (capture, donnée de crawl ou de log), l’impact estimé, le correctif recommandé et l’ordre de traitement. S’y ajoute généralement un plan d’action utilisable par vous, par votre développeur ou par votre agence. Une restitution orale en visio permet de tout reprendre ensemble, sans jargon.
6. Suivi des corrections
Je peux m’arrêter au rapport, ou accompagner la mise en œuvre : recrawl des sections corrigées, vérification dans la Search Console, et si besoin correction directement sur le site quand il est sous WordPress (Elementor Pro, WooCommerce). Sur un site non WordPress, je fournis des spécifications techniques exploitables par votre prestataire.
Délais : comptez en général de quelques jours pour un petit site vitrine à deux semaines pour un site volumineux, e-commerce ou multilingue. Le délai précis est confirmé dans le devis, avant de commencer.
Pour qui ?
TPE, PME, artisans et professions libérales
Vous n’avez pas d’équipe technique, et vous ne voulez pas en avoir une. Vous avez besoin de savoir, en clair, ce qui bloque votre site et par quoi commencer. Je m’occupe de la partie technique et je traduis : ce qui est urgent, ce qui peut attendre, ce qui n’a pas besoin d’être fait.
E-commerce (WooCommerce, Shopify)
Sur une boutique, chaque page produit, chaque filtre, chaque pagination peut créer des milliers d’URL proches. C’est le terrain de jeu préféré du gaspillage de crawl et des canonicals contradictoires. J’analyse la gestion des variantes, des filtres, des pages catégorie, des produits épuisés et des données structurées produit.
Agences web et freelances (sous-traitance, marque blanche)
Vous gérez un client dont le site rame, stagne ou ne s’indexe pas comme prévu. J’interviens en renfort technique sur la partie audit SEO technique, en votre nom et en marque blanche si vous le souhaitez. Le rapport arrive dans un format que vos équipes ou votre client peuvent exécuter directement.
Et les sites non WordPress
Je peux aussi auditer un site Shopify, Wix ou sur mesure (PHP, frameworks front). Sur ces plateformes, je n’interviens pas directement : je fournis des spécifications techniques que votre prestataire applique. Le diagnostic technique ne dépend pas du CMS : ce sont les mêmes questions de crawl, d’indexation, de rendu et de performance.
Questions fréquentes
Combien coûte un audit SEO technique ?
Le prix dépend surtout de trois choses : le nombre d’URL, la complexité technique (JavaScript, e-commerce, multilingue) et la profondeur demandée (avec ou sans analyse de logs).
Plutôt que d’afficher un tarif fixe qui ne correspondrait pas à votre situation, je vous donne un devis précis après un court échange : je regarde la taille du site, ses enjeux et ce dont vous avez réellement besoin.
Combien de temps dure un audit ?
Tout dépend de la taille du site. Un site vitrine de quelques dizaines de pages se traite en quelques jours. Un site e-commerce de plusieurs milliers d’URL, avec analyse de logs, demande plus de temps. Le délai vous est annoncé avant le démarrage.
Quelle est la différence entre un audit SEO technique et un audit SEO complet ?
L’audit SEO technique se concentre sur tout ce qui empêche les moteurs de bien lire et indexer le site : crawl, indexation, canonicals, sitemaps, rendu, performance, redirections, données structurées, hreflang. L’audit SEO complet ajoute la partie contenu et popularité : mots-clés, qualité et structure des contenus, maillage interne, profil de liens entrants, concurrence.
En pratique, je commence presque toujours par le technique : investir dans du contenu n’a pas de sens si Google ne peut pas lire correctement vos pages.
Faut-il être sur WordPress pour que vous réalisiez l’audit ?
Non. Mon métier de développeur WordPress me permet d’aller très loin sur ce CMS, notamment pour corriger moi-même les problèmes. Mais l’audit technique, je peux aussi le réaliser sur Shopify, Wix, PrestaShop ou un site sur mesure. Sur un site que je ne peux pas modifier, je vous livre des spécifications claires que votre développeur ou votre agence peut appliquer.
Réalisez-vous l’audit d’un site Shopify ou Wix ?
Oui. Sur Shopify, je regarde en particulier la gestion des collections et des filtres, les URL générées, les canonicals, la pagination, les balises produit et les Core Web Vitals. Sur Wix, je vérifie le rendu JavaScript, la structure des URL et l’indexabilité des pages. Le but est le même partout : comprendre ce que Google voit vraiment.
Que faire après l’audit ? Vous corrigez aussi ?
L’audit débouche sur un plan d’action priorisé. Ensuite, deux options. Soit vous (ou votre développeur) appliquez les correctifs, et je vérifie le résultat. Soit vous me confiez les corrections : sur WordPress, je peux intervenir directement ; ailleurs, je travaille avec votre prestataire. Cela peut aussi se transformer en suivi SEO mensuel si vous voulez traiter les points dans le temps.
L’audit garantit-il la première place sur Google ?
Non, et personne ne peut le garantir honnêtement. Le référencement dépend aussi de votre marché, de la concurrence et de la qualité de vos contenus. Ce que l’audit technique garantit, c’est de lever les obstacles qui dépendent de vous : si Google ne peut pas explorer, rendre ou indexer correctement vos pages, aucune stratégie de contenu ne compensera. On supprime le frein, puis on construit.
À quelle fréquence faut-il refaire un audit SEO technique ?
Un audit complet au démarrage, puis un contrôle régulier – au moins une fois par an, et systématiquement après une refonte, une migration de domaine, un changement de CMS ou une chute de trafic inexpliquée. Entre deux, une vérification de quelques points clés suffit souvent.
Demandez votre audit SEO technique
Vous avez maintenant une idée claire de ce que je regarde, de ce que vous recevez et de ce que ça implique. Si votre site stagne, se traîne ou ne s’indexe pas comme il devrait, le plus simple est d’en parler.
Dans le formulaire de contact, indiquez-moi l’URL de votre site, votre métier et ce qui vous préoccupe (trafic en baisse, refonte récente, lenteur, pages absentes de Google). Je vous réponds avec une première lecture et une proposition de devis claire – sans engagement et sans jargon. Et si un audit technique n’est pas le bon outil pour votre situation, je vous le dis franchement et je vous oriente vers ce qui vous servira vraiment.